Calcolo. Ricerca. Futuro.
La scienza ha bisogno di potenza.
ReCaS-Bari è il più grande centro di calcolo scientifico della Puglia e uno dei principali a livello nazionale. Qui, infrastrutture tecnologiche avanzate e competenze altamente specializzate sono messe a disposizione della comunità scientifica a supporto di numerosi progetti di ricerca di rilevanza nazionale e internazionale.
ScopriConsulta il catalogo delle attività presentate al nostro stand
↗
PartecipaTi interessano opportunità di formazione, ricerca o collaborazione?
↗
ReCaS in numeri ↓
✦HIGH PERFORMANCE COMPUTING
✦CLOUD HOSTING
✦BIG DATA
✦OPEN SCIENCE
✦ARTIFICIAL INTELLIGENCE
✦DATA STORAGE
✦REMOTE COMPUTING
simulazioni e calcolo accelerato
alla rete GARR
Le attività
presentate.
In questa sezione raccontiamo nel dettaglio le esperienze ideate dallo staff del data center per la Notte dei Ricercatori 2026, insieme alle idee e alle scelte che hanno guidato la loro realizzazione.
01
MACHINE
MEETS
POETRY
MEETS
POETRY
Introduzione teorica · Intelligenza artificiale
Intelligenza Artificiale: un modello che farnetica in stile dantesco
↗Installazione partecipativa · Per tutti
Cloud hosting: Lascia un messaggio per il mondo (feat. Dante)
↗
03
10 MACCHINE
100 MILIONI DI PUNTI
UN RISULTATO COMUNE
100 MILIONI DI PUNTI
UN RISULTATO COMUNE
Introduzione teorica · Calcolo scientifico
Tanti computer, un compito comune: calcolare π
↗Attività 01 · Intelligenza artificiale
Intelligenza Artificiale:
un modello che farnetica
in stile dantesco.
MACHINE
MEETS
POETRY
MEETS
POETRY
DAL CONCETTO AL CODICE
Una piccola guida
all’intelligenza artificiale.
01 Partiamo dalle aspettativeIntroduzione
Quando si parla di intelligenza artificiale si pensa subito a sistemi come ChatGPT o chatbot affini: sistemi capaci di sostenere conversazioni, scrivere codice e lavorare con grandi quantità di conoscenza.
È un riferimento comprensibile, ma rappresenta la fascia più complessa e costosa dell’AI. I sistemi di frontiera nascono all’interno di programmi industriali con investimenti nell’ordine dei miliardi. Una fase di addestramento può tenere occupate migliaia o decine di migliaia di GPU — le cosiddette “schede grafiche”, progettate per eseguire moltissimi calcoli in parallelo e, nei modelli più potenti, molto più costose dei comuni processori — per settimane o mesi: in totale, un ordine di grandezza di milioni di GPU-ore. A questo si aggiunge il lavoro umano necessario per preparare i dati, progettare l’infrastruttura, valutare le risposte e migliorare sicurezza e affidabilità. I dettagli esatti dei modelli usati da ChatGPT non sono pubblici, quindi questi numeri descrivono la scala dei sistemi di frontiera, non una specifica versione.
Ma l’AI non comincia da quella scala. Con un normale computer, un dataset circoscritto e poche righe di codice si può costruire in breve tempo un’applicazione molto più limitata, ma già capace di imparare uno schema. In questa sezione viene considerato un caso volutamente semplice, così da mettere a fuoco proprio questo principio fondamentale.
02 Numeri che imparano dai datiCosa significa addestrare una rete
La parola “intelligenza” può trarre in inganno: in una rete neurale non c’è una mente che pensa o comprende, ma matematica e statistica applicate ai dati.
Addestrare una rete significa farle maturare una sorta di “esperienza” numerica: osservando molti esempi, il sistema individua le regolarità che ricorrono più spesso e le usa per formulare una previsione.
Una rete neurale è, in sostanza, una grande funzione matematica composta da tanti parametri regolabili: i pesi. All’inizio sono soltanto numeri quasi casuali.
Durante l’addestramento vengono mostrati al modello molti esempi. Per ciascuno viene richiesta una previsione, si misura quanto differisce dalla risposta corretta attraverso una funzione di errore — la loss — e i pesi vengono modificati leggermente nella direzione che riduce quell’errore. Ripetendo il ciclo migliaia di volte, i numeri finiscono per codificare regolarità presenti nei dati.
01EsempioIl modello riceve un dato
→
02ErroreConfronta previsione e risposta
→
03CorrezioneAggiorna di poco i pesi
↻
Il risultato dell’addestramento non è un elenco di regole scritto da una persona: è un insieme di numeri che rende alcune risposte statisticamente più probabili di altre.
03 Dal testo alla previsione del carattere successivoUn piccolo modello per emulare Dante
Il testo della Divina Commedia viene trasformato in sequenze di caratteri e a una piccola rete di intelligenza artificiale viene posta sempre la stessa domanda: dato ciò che è stato appena letto, quale carattere viene dopo?
Il testo dell’opera viene suddiviso in finestre di 30 caratteri. Le finestre non sono separate: ciascuna inizia 3 caratteri dopo la precedente e ne condivide quindi 27 con essa. In questo modo i 558.240 caratteri della Divina Commedia diventano 186.070 esempi. Nel testo sono presenti 40 caratteri distinti, tra lettere, segni di punteggiatura, spazi e altri simboli.
Leggendo questi esempi, la rete prova a imparare quale carattere abbia statisticamente più probabilità di comparire dopo una determinata sequenza, sulla base delle regolarità incontrate durante l’addestramento.
Quando viene generato un nuovo testo, la composizione procede quindi lettera per lettera e si basa esclusivamente su questo processo statistico: viene aggiunto il carattere considerato più probabile, poi il procedimento ricomincia.
558kcaratteri totali
40simboli distinti
60iterazioni (dette epoche nel gergo)
OUTPUT · EPOCA 59GENERAZIONE GREEDY
«Tosto che l’anima mi venne a l’oscia
che sarà non si venne ancor sì spesso,
non so che non si tresto a la mente…»
Il risultato non ha un significato compiuto e inventa parole: il modello ha poco contesto, un dataset minuscolo rispetto a un chatbot moderno e nessuna vera conoscenza dell’italiano. Eppure apprende qualcosa di riconoscibile: apostrofi, interruzioni di verso, ritmo, costruzioni ricorrenti e frammenti che ricordano il volgare dantesco. Non ha imparato cosa Dante volesse dire; ha imparato alcuni pattern statistici di come quel testo appare.
È possibile scaricare il codice di training.
04 Metti alla prova il tuo orecchioIl verso è di Dante o dell’AI?
Alcuni versi sono autentici, altri provengono dal piccolo modello. Basta scegliere una risposta per scoprire quanto la forma possa ingannare l’orecchio umano.
«Chi poria mai pur con parole sciolte»
«Non possemo altri sempre sanza schiera»
«Suso in Italia bella giace un laco»
«La terra che là su si fece a la mente»
«Che l’anima mi fece al mondo son dispresso»
«Sovra candido vel cinta d’uliva»
05 Oltre le paroleL’intelligenza artificiale non è solo chiacchiere
L’AI non deve necessariamente imparare a parlare. Può cercare regolarità in quasi ogni dataset, purché i dati siano abbastanza puliti, comprensibili e rappresentativi del problema.
Lo stesso principio — trasformare esempi in numeri, misurare l’errore e correggere dei parametri — permette a modelli relativamente piccoli come quello che abbiamo appena trattato di affrontare compiti molto diversi.
DATI TABELLARI01
Chi è sopravvissuto al Titanic?
In questo esempio, 891 passeggeri diventano le righe di una tabella. Classe del biglietto, sesso, fascia d’età, tariffa, porto d’imbarco, titolo e presenza di familiari sono sufficienti perché un modello relativamente piccolo riesca a prevedere la sopravvivenza con un’accuratezza vicina al 90%.
Questo è possibile perché, sotto la superficie, quei dati contengono informazioni legate alle probabilità di sopravvivenza: l’età, per esempio, può riflettere indirettamente la prestanza fisica. Le persone possono intuire alcune di queste relazioni, ma difficilmente riescono a quantificare il peso di ogni fattore e delle loro combinazioni; il modello prova a farlo statisticamente.
ETÀCLASSETARIFFAFAMIGLIA
NEI DATI STORICI
342 su 891
passeggeri sopravvissuti
QUOTA DI SOPRAVVIVENZA
Donne74%
Uomini19%
1ª classe63%
2ª classe47%
3ª classe24%
IMMAGINI02
Che cifra è stata scritta?
Immaginiamo di voler leggere automaticamente le cifre compilate a mano su moduli, buste o documenti. La grafia cambia da persona a persona: i numeri possono essere storti, schiacciati, incompleti o scritti con tratti molto diversi.
Per insegnare questo compito al modello si raccolgono migliaia di esempi, ognuno ridotto a una piccola immagine in scala di grigi da 28 × 28 pixel. La rete non vede una “cifra” come la vede una persona: riceve 784 valori numerici e impara quali configurazioni di pixel ricorrono più spesso per ciascun numero.
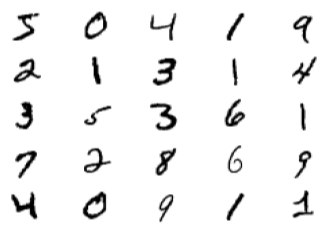
Anche un modello piccolo, addestrato in pochi minuti con una GPU noleggiata gratuitamente online, può affrontare un compito del genere. Il valore pratico è enorme: lo stesso principio può riconoscere non soltanto cifre, ma anche lettere, parole, codici e altri segni, aiutando ad automatizzare e industrializzare processi ripetitivi di lettura e classificazione.
La capacità di riconoscere schemi nelle immagini viene applicata sempre più anche in medicina. Su alcuni compiti diagnostici ben definiti, per esempio l’analisi di determinate radiografie, sistemi di AI hanno raggiunto o superato le prestazioni di radiologi esperti.
Il confronto riguarda compiti e dataset specifici: le prestazioni devono sempre essere validate nel contesto clinico. Approfondisci lo studio ↗06 Un cambio di scala · Verso la prossima attivitàDai piccoli esperimenti a un modello ospitato a ReCaS
Fin qui sono stati introdotti i concetti teorici alla base dell’intelligenza artificiale e alcuni esperimenti in piccola scala: modelli costruiti “in casa”, in poco tempo e con risorse molto limitate. Sono esempi utili per osservare il meccanismo dell’apprendimento, ma lontani dalla potenza dei sistemi utilizzati ogni giorno da milioni di persone.
I modelli impiegati da servizi come ChatGPT o Claude Code operano su una scala completamente diversa. Dietro le loro prestazioni ci sono investimenti enormi, grandi quantità di dati, infrastrutture specializzate e un lungo lavoro umano di progettazione, valutazione e perfezionamento. Sono prodotti commerciali: non vengono eseguiti sul computer dell’utente, ma nei data center del fornitore.
Quando si invia una richiesta, il testo raggiunge attraverso Internet quelle macchine, viene elaborato e la risposta torna al dispositivo dell’utente. È un meccanismo molto comodo, ma introduce costi, dipendenza dal servizio e questioni importanti sulla privacy e sulla gestione dei dati trasmessi.
Modelli avanzati, eseguiti localmente
Esistono però anche modelli molto prestanti, spesso vicini a quelli commerciali in numerosi compiti, i cui pesi vengono distribuiti pubblicamente. Come si è già visto, i pesi sono i parametri numerici prodotti durante l’addestramento: rendendoli scaricabili, il modello può essere riprodotto ed eseguito su una macchina propria, senza dover affidare ogni richiesta a un servizio esterno.
Il loro addestramento resta costoso e complesso ed è svolto da grandi gruppi di esperti; ciò che viene condiviso è il risultato di quel lavoro. Per la prossima esperienza è stato scaricato uno di questi modelli, chiamato Qwen2.5-32B-Instruct-AWQ, e installato su una macchina di ReCaS. Possiede circa 32 miliardi di parametri, cioè i valori numerici appresi durante l’addestramento che fin qui sono stati chiamati pesi. La macchina dispone di una GPU NVIDIA H100 con 80 GB di memoria: un componente progettato per accelerare i calcoli di intelligenza artificiale nei data center, dal valore indicativo nell’ordine dei 30.000 euro per singola unità. Questa infrastruttura può eseguire localmente un chatbot capace di interpretare una richiesta e generare una risposta articolata, offrendo un’esperienza simile, nel funzionamento, a quella di servizi come ChatGPT, seppur meno prestante.
Il passaggio successivo: il cloud hosting
Nella prossima attività si parlerà di cloud hosting: il principio che permette di rendere disponibili su Internet siti e applicazioni eseguendoli su server sempre connessi, spesso ospitati e gestiti proprio all’interno di data center.
Questo concetto verrà messo in pratica attraverso una pagina web dedicata, sulla quale i visitatori dello stand potranno lasciare un messaggio rivolto a chi desiderano. La pagina generata sarà raggiungibile da qualunque luogo tramite Internet attraverso un indirizzo unico.
Per riunire quanto visto finora, ogni messaggio verrà rielaborato dal modello Qwen2.5 installato localmente a ReCaS e trasformato nel suo “corrispettivo dantesco”, conservandone il significato. Qwen2.5 è decisamente più prestante del piccolo modello presentato all’inizio della pagina: può tenere conto del contesto, della struttura del linguaggio e del significato complessivo del testo, risultando quindi pienamente adeguato a questo compito.
DAL SERVER AL MONDO
Una piccola guida
al cloud hosting.
01 Dietro ciò che appare sullo schermoCome funziona davvero Internet?
La nostra quotidianità passa continuamente dalla rete: apriamo siti, leggiamo notizie e usiamo applicazioni che recuperano contenuti online senza mostrarci ciò che accade dietro l’interfaccia. È quindi naturale chiedersi: da dove arrivano davvero tutte queste informazioni?
Il modello più comune è chiamato architettura client–server. Il client è il programma con cui chiediamo qualcosa — per esempio il browser o un’app sul telefono. Il server riceve la richiesta, cerca i file o i dati necessari e invia una risposta. Il browser — il software o l’applicazione con cui navighiamo in Internet, come Google Chrome, Safari o Firefox — usa poi quella risposta per costruire ciò che vediamo sullo schermo.
Non bisogna pensare ai server come a computer necessariamente speciali: il termine fa riferimento soprattutto al ruolo svolto dalla macchina. Anche un normale PC domestico può diventare un server: se configurato correttamente e reso raggiungibile dalla rete, può pubblicare un sito accessibile dall’esterno.
Il viaggio della richiesta dal client al server avviene secondo regole condivise, chiamate protocolli. Nel Web si usa soprattutto HTTP e la sua controparte cifrata e sicura, HTTPS: questo protocollo stabilisce come formulare una richiesta e come restituire una risposta.
Questo spiega perché molti indirizzi condivisi iniziano con https://: quella parte indica semplicemente il protocollo da usare. Nei browser moderni può quasi sempre essere omessa, perché il programma prova automaticamente ad aprire il sito tramite HTTPS. Per esempio, scrivere google.com nella barra degli indirizzi conduce normalmente allo stesso sito indicato dall’indirizzo completo https://google.com.
RICHIESTA HTTPS
→
Fin qui il meccanismo sembra lineare: un client domanda, il server risponde. Bisogna però tenere conto dei problemi che possono emergere quando questo modello viene applicato su larga scala. Immaginiamo, per esempio, un social network o un altro servizio usato da milioni di persone: un solo computer non può gestire in autonomia milioni di richieste al secondo. Inoltre rappresenterebbe un singolo punto di guasto: un problema a quella macchina o all’infrastruttura a cui è collegata potrebbe rendere irraggiungibile l’intero servizio.
Carico
Molti visitatori possono chiedere contenuti nello stesso istante. Il lavoro deve essere distribuito tra più macchine: se una singola macchina si sovraccarica, smette di funzionare correttamente.
Guasti
Dischi, reti e computer possono smettere di funzionare. Avere copie e percorsi alternativi evita che un singolo problema fermi tutto.
Distanza
Più il server è lontano, più tempo impiegano richiesta e risposta. Distribuire i servizi riduce l’attesa percepita.
Concentriamoci sul terzo punto: la distanza. In genere, il ritardo tra la richiesta del client e la risposta del server prende il nome di latenza. Una parte della latenza dipende proprio dalla distanza tra i due punti: in una fibra ottica il segnale viaggia a circa 200.000 chilometri al secondo, quindi il trasferimento non è immediato.
La latenza, però, non dipende soltanto dalla lunghezza della linea che unisce client e server. Il percorso reale non è quasi mai diretto: i dati attraversano cavi, apparati di rete e diversi nodi intermedi — i router. Ciascun passaggio richiede un piccolo tempo di elaborazione, che si somma al tempo impiegato dall’informazione per percorrere fisicamente la rete.
Per questo motivo — e per affrontare anche i problemi di carico e affidabilità — i grandi servizi vengono eseguiti contemporaneamente su molti server, spesso distribuiti in aree geografiche differenti.
Distribuire un servizio risolve alcuni problemi, ma ne introduce altri. Nasce infatti una nuova domanda: come mantenere coerenti le informazioni tra tutte queste copie? I dati devono essere replicati e sincronizzati; le richieste devono essere indirizzate verso macchine disponibili; i guasti devono essere rilevati e gestiti.
Insomma, più ci si riflette e più si arriva a una conclusione importante:
Più osserviamo da vicino il funzionamento di Internet — una risorsa tanto presente e affidabile da sembrarci quasi “naturale” — più scopriamo una rete di problemi e scelte invisibili. Ciò che utilizziamo con tanta facilità è invece il risultato artificiale del lavoro continuo di milioni di persone, che progettano, costruiscono e mantengono sistemi complessi in ogni parte del mondo.
Torniamo ora al nostro argomento principale. Anche un sito molto più piccolo di un social network deve rispondere a una domanda concreta: dove può funzionare il server affinché la pagina rimanga raggiungibile?
È nella risposta a questa domanda che entrano in gioco i concetti di hosting, data center e cloud computing.
02 Dalle macchine reali alla nuvolaHosting, data center e “il mondo Cloud”
Dare a un sito una “casa” su una macchina connessa alla rete, affinché possa rispondere alle richieste dei visitatori, è ciò che chiamiamo hosting.
In termini più precisi, significa eseguire un sito o un’applicazione su un server raggiungibile attraverso Internet e predisporre tutto ciò che serve perché continui a funzionare. È facile ottenere una pagina visibile per qualche minuto; è molto più difficile renderla disponibile con continuità, in sicurezza e anche quando qualcosa va storto.
In teoria, anche un comune computer di uso casalingo potrebbe svolgere questo compito. Dovrebbe però rimanere sempre acceso, dipenderebbe dalla connessione domestica e richiederebbe a chi lo gestisce di occuparsi di aggiornamenti, sicurezza, copie dei dati e possibili guasti. Persino per un piccolo progetto, sono responsabilità poco pratiche da sostenere giorno e notte.
Per questi motivi, i server vengono spesso predisposti all’interno di un data center: una struttura costruita appositamente per ospitare e mantenere operative macchine e servizi informatici. Qui troviamo connessioni veloci, alimentazione e raffreddamento controllati, monitoraggio, protezioni fisiche e sistemi di riserva. Nessun servizio è magicamente infallibile, ma l’infrastruttura è progettata per ridurre le interruzioni e mantenere le macchine raggiungibili con elevata continuità.
24/7l’obiettivo è essere raggiungibili giorno e notte
RETEconnessioni ad alta capacità e percorsi ridondanti
RISERVAenergia, copie e sistemi pronti in caso di guasto
CONTROLLOmonitoraggio continuo di macchine e servizi
Una macchina collocata in un data center non deve essere utilizzata davanti a uno schermo e a una tastiera fisicamente collegati. Attraverso Internet e protocolli appositi può essere raggiunta e amministrata a distanza: lo sviluppatore può impartire comandi, installare programmi, trasferire il codice della propria applicazione, avviarla e aggiornarla. In pratica, può controllare da remoto un computer che si trova altrove e usarlo per rendere disponibile il proprio servizio su Internet.
Quando capacità di calcolo, memoria, archiviazione e rete vengono offerte da remoto e possono essere attivate o adattate secondo le necessità, parliamo di cloud computing. Quando queste risorse vengono usate per pubblicare un sito o un’applicazione, parliamo più precisamente di cloud hosting. La parola inglese cloud significa letteralmente nuvola.
Il nome può ingannare: non c’è nulla di immateriale, nessuna “nuvola” lontana. Nei diagrammi tecnici Internet e le reti esterne venivano spesso rappresentate con una nuvola, perché mostrarne tutti i collegamenti avrebbe reso il disegno illeggibile. Quel simbolo è diventato il nome di un modello di servizio, ma dietro la “nuvola” continuano a esserci edifici, server, dischi, cavi, energia e persone che amministrano l’infrastruttura.
Il vantaggio per chi sviluppa un’applicazione è dunque tangibile: può concentrarsi sul servizio da realizzare senza dover acquistare, installare e sorvegliare personalmente ogni componente fisico. Il server rimane reale, una macchina fisica; è la sua gestione a diventare più distante e, per chi lo utilizza, più semplice.
03 La stessa risposta o una pagina su misuraPagine statiche e pagine dinamiche
Non tutte le pagine che richiediamo a un server esistono già, complete in ogni loro parte. Molte vengono costruite nel momento stesso in cui sono richieste, in base all’utente che effettua la richiesta, ai dati disponibili o ad altri fattori.
Un esempio è la pagina di benvenuto di un servizio bancario: dopo l’accesso, il server riconosce l’utente e prepara una risposta personale, mostrando informazioni come il suo nome, il saldo e i movimenti del conto. La struttura della pagina rimane simile per tutti, ma i dati visualizzati cambiano da persona a persona.
Già pronta
Il server invia gli stessi contenuti a ogni visitatore: è il caso ideale per pagine informative che cambiano raramente.
/chi-siamo.html
Creata dai dati
Il server recupera i dati associati all’utente e costruisce la pagina al momento: lo stesso indirizzo può quindi mostrare informazioni differenti a persone diverse.
/m/ciao-nadira
Le pagine dei messaggi di questa esperienza sono dinamiche: condividono la stessa veste grafica, ma testi, firma e QR code cambiano in base all’indirizzo visitato.
04 Cloud hosting, ma in miniaturaUna pagina per ogni messaggio
In questa attività ogni visitatore pubblicherà una piccola pagina web raggiungibile tramite Internet, scegliendone personalmente il contenuto e l’indirizzo.
Si raccolgono un messaggio, una firma e un nome per la pagina tramite un modulo di sottomissione. Il server controlla che quell’indirizzo non sia già stato usato e conserva i dati; da quel momento, chi visita il link riceve la pagina associata a quel messaggio.
Non viene quindi creato a mano un nuovo sito ogni volta, ma una nuova pagina all’interno di questo stesso sito. È una versione in miniatura dello stesso principio illustrato fin qui e usato da social network, negozi online e moltissimi servizi sul Web.
Compilamessaggio, firma e URL
→
Salvail server conserva i dati
→
Pubblicala pagina diventa raggiungibile
→
Condividitramite link o QR code
05 Il collegamento con l’attività precedenteDove entra in gioco l’intelligenza artificiale?
Prima della pubblicazione, il messaggio compie una deviazione: viene affidato a un modello di intelligenza artificiale ospitato localmente su una macchina di ReCaS.
Il sito contatta il modello tramite Internet; il modello interpreta il testo inserito e lo riscrive in non meno di due versi, richiamando lo stile di Dante senza cambiarne il significato.
Il risultato torna al server su cui è stato hostato questo sito web e viene salvato insieme al messaggio originale. La pagina finale può così mostrare entrambi, mentre un QR code codifica il suo indirizzo e permette di aprirla rapidamente da un altro dispositivo.
IN PARTENZA«Ci vediamo domani davanti al mare»
HTTPS →
RECAS · GPU H100Modello I.A.comprende · trasforma · risponde
→ WEB
ALL’ARRIVODimani, presso l’onde marine,
ci troverem l’un lato dell’altre.
ci troverem l’un lato dell’altre.
06 Dalla spiegazione all’esperienzaÈ il momento di lasciare il tuo messaggio
Ora tocca a te: scegli cosa affidare al mondo, lascia che il modello di intelligenza artificiale lo trasformi e pubblica la tua piccola pagina sul Web.
Al termine potrai aprire immediatamente il risultato, copiarne il collegamento oppure usare il QR code per condividerlo. Ricorda che messaggio e firma saranno visibili a chiunque possieda l’indirizzo: evita dati personali o informazioni riservate.
INIZIA L’ESPERIENZA
Crea il tuo
Crea il tuo
messaggio dantesco
Scrivi · trasforma · pubblica
→Attività 03 · Calcolo scientifico
Tanti computer, un compito comune:
calcolare π
100 milioni di punti · 10 macchine · un paio di minuti
LE RISORSE DI CALCOLO AL SERVIZIO DELLA RICERCA
Una piccola guida
al calcolo scientifico.
01 La potenza nasce dalla collaborazioneCome funziona un centro di calcolo (“super computer”) come ReCaS?
Quando si parla di un “super computer”, si pensa spesso a un unico PC gigantesco. Nei sistemi moderni, invece, la potenza nasce generalmente da un cluster: tante macchine collegate in rete e gestite insieme.
La parola inglese cluster significa “gruppo”. In questo caso indica un insieme di computer, chiamati nodi, ciascuno dotato delle proprie risorse di calcolo. Collegando e coordinando i nodi, queste risorse possono essere gestite come se facessero parte di un’unica grande macchina: il sistema le assegna in modo trasparente a molti lavori e programmi diversi oppure le combina per affrontare elaborazioni particolarmente impegnative, come complesse analisi scientifiche.
Tra i vari servizi offerti da ReCaS Bari c’è proprio la fornitura di un’infrastruttura di calcolo: computer, rete, spazio per i dati e strumenti di gestione sui quali i ricercatori possono eseguire i propri programmi. Ma perché affidare un lavoro al data center, anziché avviarlo sul proprio PC?
02 Quando il proprio PC non bastaPerché usare un centro di calcolo?
Una simulazione può durare giorni. Un’analisi può richiedere più memoria di quella disponibile sul proprio PC. Oppure può essere necessario ripetere lo stesso esperimento migliaia di volte, cambiando ogni volta i dati di partenza.
Il problema non è soltanto la velocità. Chi fa ricerca ha bisogno di risorse adatte, di tempo per usarle e di un modo comodo per organizzare il lavoro.
Più capacità
Il centro offre processori, memoria e, quando servono, acceleratori che possono superare le possibilità di un computer personale. Consente anche di eseguire molti lavori contemporaneamente.
Il lavoro continua
Un calcolo affidato al sistema può proseguire per ore o giorni, nei limiti assegnati, anche dopo che il ricercatore ha chiuso la connessione e spento il portatile.
Il PC rimane libero
Mentre le macchine del centro calcolano, il ricercatore può usare il proprio computer per scrivere, studiare o preparare altre analisi. Ritroverà risultati e informazioni sull’esecuzione quando saranno disponibili.
Risorse da usare
Non occorre acquistare e gestire personalmente tutte le macchine necessarie. Il data center si occupa dell’infrastruttura, che può essere utilizzata da più gruppi di ricerca secondo regole comuni.
Naturalmente le risorse non sono infinite: se molte persone ne hanno bisogno nello stesso momento, occorre decidere quali lavori avviare, dove e con quale priorità. È qui che entra in gioco il batch system.
03 La regia del lavoroIl batch system: il cuore pulsante del cluster di calcolo
Un batch system è un sistema software al quale si affidano lavori da eseguire senza doverli seguire passo dopo passo. Riceve le richieste, le organizza in coda e ne gestisce l’esecuzione sulle risorse disponibili.
Ogni lavoro sottomesso al cluster prende il nome di job. Il ricercatore prepara il programma, i dati da elaborare e le istruzioni per avviarlo; indica anche le risorse necessarie, per esempio quanti processori e quanta memoria servono e, dove richiesto, per quanto tempo.
Prepara e invia
Descrive che cosa eseguire e di quali risorse ha bisogno. Può inviare un singolo job oppure molti lavori, senza aprire una connessione a ogni macchina.
Organizza la coda
Controlla quali risorse sono libere e quali sono adatte alle richieste. Tiene conto di priorità e regole di condivisione: i lavori non partono necessariamente nell’ordine di arrivo.
Eseguono i job
Quando le risorse necessarie diventano disponibili, il sistema avvia i programmi e ne segue lo stato. Ogni lavoro usa le risorse che gli sono state assegnate.
Raccoglie i risultati
Controlla se i lavori sono terminati, recupera i file prodotti e consulta eventuali errori. Non deve essere presente davanti allo schermo per tutta la durata del calcolo.
Questa regia evita che ciascuno tenti di usare le stesse macchine senza coordinarsi e aiuta a sfruttare l’infrastruttura in modo ordinato. Un job può anche usare un solo processore: il batch system è utile per organizzare il lavoro, non soltanto per fare calcoli paralleli.
Esistono diversi software per questo compito: HTCondor, usato a ReCaS, e Slurm sono due esempi.
04 Due modi di mettere insieme la potenzaLavori indipendenti o un calcolo condiviso?
Tra le possibilità offerte da un cluster c’è anche il calcolo parallelo: svolgere più parti di un lavoro nello stesso momento. Il modo di farlo dipende da quanto queste parti hanno bisogno l’una dell’altra.
Tanti lavori indipendenti
L’obiettivo è completare una grande quantità di lavoro nel tempo. Un caso tipico è eseguire molti job indipendenti: ciascuno elabora i propri dati e può proseguire senza aspettare gli altri. Si possono far partire in parallelo e, quando serve, riunire i risultati alla fine.
Immagina di distribuire diecimila fotografie tra più persone, chiedendo a ciascuna di contare gli oggetti nelle immagini ricevute. Ognuno può lavorare per conto proprio; poi si raccolgono i conteggi.
Parti che comunicano
L’obiettivo è ottenere prestazioni elevate su calcoli impegnativi. Un caso tipico è un unico job parallelo diviso tra più macchine: durante l’esecuzione le parti si scambiano dati e devono coordinarsi per poter proseguire. La velocità della rete diventa quindi fondamentale.
Pensa a una simulazione del meteo divisa in zone: ciò che accade in una zona influenza quelle vicine. A ogni passo del calcolo, le parti devono scambiarsi le informazioni necessarie a simulare il passo successivo.
Nel primo caso è come avere molte attività autonome; nel secondo, una squadra i cui componenti devono aggiornarsi mentre lavorano. Le sigle HTC e HPC descrivono soprattutto obiettivi diversi, non due categorie completamente separate: un centro può ospitare entrambe le modalità. Anche i job paralleli che comunicano possono essere gestiti da un batch system.
Prima di passare a un esempio concreto, resta una domanda pratica: quanto di questa organizzazione deve gestire chi vuole semplicemente eseguire un programma?
05 La complessità dietro un semplice fileChe cosa cambia per chi usa il cluster?
L’organizzazione di un cluster può sembrare complessa. Uno dei punti di forza del batch system è proprio rendere gran parte di questa gestione trasparente per l’utente: non occorre scegliere personalmente la macchina né sorvegliarne l’esecuzione.
Si consideri un esempio. Si supponga di voler avviare sul proprio PC un programma di analisi scritto in Python, un linguaggio di programmazione. Il programma in questione può essere eseguito con il seguente comando:
python3 esegui_calcolo_complesso.pySupponendo di voler eseguire la stessa analisi su un batch system, si opera invece tramite un submit file, o file di sottomissione: un semplice file di testo che descrive il programma da eseguire, dove salvarne i risultati — l’output — e quali risorse assegnargli. Il contenuto può essere rappresentato così:
programma = python3 esegui_calcolo_complesso.py

file_output = calcolo.out

memoria_richiesta      = 10 GB
processori_richiesti   = 1
gpu_richieste          = 3
Esempio schematico: i nomi dei campi sono illustrativi. La sintassi effettiva dipende dal software utilizzato per orchestrare il cluster.
Oltre al comando, vengono richiesti 10 GB di memoria, un’unità di elaborazione della CPU e tre GPU, cioè acceleratori adatti a determinati calcoli. Sono quantità di esempio: ogni programma richiede risorse diverse e deve essere progettato per sfruttarle. Chiedere tre GPU non rende automaticamente più veloce un programma che non le usa.
Una volta sottomesso il file, il sistema mette il job in coda. Quando trova una macchina compatibile con una porzione di risorse libera — spesso chiamata slot — gli assegna quanto richiesto e avvia il programma, rispettando le priorità del cluster. Se le risorse non sono disponibili, il lavoro rimane in attesa.
Il testo che il programma avrebbe stampato sullo schermo viene raccolto nel file calcolo.out. Gli eventuali altri risultati, come immagini o tabelle, vengono salvati secondo le istruzioni del programma. L’utente può quindi recuperare l’output senza dover conoscere in anticipo la macchina che ha eseguito il calcolo.
Resta necessario preparare il programma e i dati e assicurarsi che siano disponibili nell’ambiente di esecuzione. La scelta delle risorse libere e l’avvio del job vengono invece gestiti dal sistema. L’esempio di π permette di osservare questo meccanismo con un compito semplice e facilmente divisibile.
06 Un esempio semplice su cui costruireCalcolo di π attraverso simulazione statistica
Si immagini di lanciare cento milioni di palline in un quadrato e contare quante cadono dentro una figura disegnata al suo interno. Il compito è semplice; ripeterlo cento milioni di volte è un altro discorso.
La sfida riguarda un numero familiare: π, il pi greco, circa 3,14159… È il rapporto tra la lunghezza di una circonferenza e il suo diametro. In questo esperimento se ne ricava una stima usando punti casuali: le “palline” sono soltanto coppie di numeri generate dai computer.
Per capire il principio alla base di questa simulazione, basta pensare al lancio di una moneta equilibrata: testa e croce hanno entrambe una probabilità del 50%. Eppure, lanciandola dieci volte, non è affatto garantito ottenere cinque teste e cinque croci. Su pochi tentativi, il caso può produrre uno squilibrio evidente.
Continuando con tanti lanci indipendenti, la percentuale di teste tende ad avvicinarsi al 50%, così come quella di croci. È il principio della legge dei grandi numeri: al crescere del numero di prove, le frequenze osservate tendono alle probabilità teoriche.
Questo modo di procedere — rappresentare un problema attraverso un modello teorico, simulare un grandissimo numero di casi casuali e osservare il risultato complessivo — prende il nome di metodo Monte Carlo. Permette di stimare o verificare numericamente un risultato previsto dal modello, sfruttando la statistica anziché risolvere direttamente ogni passaggio del problema. Il nome richiama il celebre casinò di Monte Carlo e i suoi giochi d’azzardo: qui, però, il caso diventa uno strumento di calcolo. Simulare un modello consente quindi di studiarne le conseguenze anche quando ricavarle con un calcolo diretto sarebbe molto difficile; verificare che rappresenti bene la realtà rimane un passaggio distinto.
Per π si userà lo stesso principio: al posto dei lanci di moneta, si simuleranno punti casuali nel quadrato. La frazione che cade nella figura permetterà di stimare π. Come per la percentuale di teste, servono moltissime prove per ottenere una stima precisa: ecco perché questo esperimento prevede cento milioni di punti.
Chiaramente, esistono modi molto più efficienti per calcolare le cifre di π. Questo esempio è stato scelto perché rende visibile un’idea utile anche in problemi scientifici ben più complessi: tante prove indipendenti possono essere distribuite tra tante macchine ed eseguite contemporaneamente.
07 Dal disegno al numeroUn quadrato, un arco e un po’ di caso
Si consideri un quadrato di lato 1 metro. Nell’angolo in basso a sinistra si colloca il centro di un cerchio di raggio 1 metro: dentro al quadrato ne entra esattamente un quarto. Il raggio è la distanza dal centro al bordo del cerchio.
L’area misura quanta superficie occupa una figura. Se le lunghezze sono espresse in metri, l’area si misura in metri quadrati (m²). I valori dell’esempio si ricavano dalle seguenti formule:
Lato × lato
L’area di un quadrato si ottiene moltiplicando la lunghezza del lato per sé stessa.
A = lato × lato
A = 1 m × 1 m = 1 m²
Un quarto dell’area
L’area del cerchio intero è π moltiplicato per il raggio al quadrato, cioè per il raggio moltiplicato per sé stesso.
A del cerchio = π × raggio²
A del cerchio = π × (1 m)² = π m²
Poiché se ne considera solo un quarto, l’area va divisa per 4:
A del quarto di cerchio = (π / 4) m²
Il rapporto tra le due aree è dunque [(π / 4) m²] / [1 m²] = π / 4. Le unità di misura si semplificano: si ottiene un numero che indica quale frazione del quadrato è occupata dal quarto di cerchio.
Si generano poi punti casuali distribuiti uniformemente nel quadrato, senza favorire il centro, i bordi o altre zone. “Uniformemente” significa che due regioni di uguale area hanno la stessa probabilità di essere colpite; una regione grande il doppio ha una probabilità doppia. Non basta, quindi, generare punti casuali in un modo qualsiasi: conta anche come vengono distribuiti.
Di conseguenza, la probabilità che un punto cada nel quarto di cerchio è proprio la frazione di superficie che esso occupa: π / 4. Con tanti punti indipendenti, la proporzione di quelli interni tende a questa probabilità, proprio come la percentuale di teste tende al 50% nell’esempio della moneta. Moltiplicando per 4, si ottiene quindi una stima di π:
DAL CONTEGGIO ALLA STIMA
π ≈ 4 ×punti dentropunti totali
Per esempio: 785 punti dentro su 1.000 punti totali danno una stima di 3,14.
Il computer riconosce i punti interni usando le loro coordinate, x e y, cioè le distanze orizzontale e verticale dall’angolo. Per il teorema di Pitagora il punto è dentro, o sul bordo, se x² + y² ≤ raggio². In questo esempio il limite è (1 m)² = 1 m². Nel programma si usano direttamente i valori numerici delle coordinate in metri, da 0 a 1: il controllo diventa x² + y² ≤ 1.
Alla luce di quanto visto, e come mostra il grafico, all’aumentare del numero di punti la stima di π tende, in media, a diventare più precisa.
08 Dieci parti dello stesso esperimentoCome si divide il calcolo?
Ogni punto può essere generato e controllato senza aspettare gli altri. È una situazione ideale per il calcolo parallelo: più macchine possono lavorare nello stesso momento su parti diverse del problema.
In questo esempio si affidano al batch system dieci job, da eseguire su dieci macchine del cluster ReCaS. Ciascuno genera dieci milioni di punti con una sequenza casuale indipendente e conta quanti sono interni al quarto di cerchio. È l’esempio di lavori indipendenti descritto prima: non devono scambiarsi dati mentre calcolano.
100 milioni di punti
Il batch system assegna dieci lavori alle risorse disponibili.
0110 milioni0210 milioni0310 milioni0410 milioni0510 milioni0610 milioni0710 milioni0810 milioni0910 milioni1010 milioni
SI RIUNISCONO I CONTEGGIUna stima comune di π
Si sommano i punti interni e i punti totali di tutte le macchine, poi si applica la stessa formula.
Ogni macchina può mostrare un proprio valore approssimato di π. Il risultato finale, però, tiene conto di tutti i cento milioni di punti, anziché selezionare la macchina che ha avuto più fortuna. Sommando i conteggi, il metodo resta corretto anche se i lavori contengono numeri diversi di punti.
Dividere il lavoro può ridurre il tempo di attesa, ma dieci macchine non significano automaticamente un tempo dieci volte più breve. Ci sono attese in coda, avvio dei programmi e raccolta dei risultati; inoltre le macchine possono avere velocità differenti. Il vantaggio dipende da quanto lavoro può davvero essere svolto contemporaneamente.
L’obiettivo resta comunque ottenere il risultato in meno tempo. In un caso facilmente divisibile come questo, con dieci macchine di prestazioni simili che lavorano contemporaneamente, il tempo del solo calcolo può avvicinarsi a un decimo di quello necessario su una sola macchina. È un riferimento ideale, non una garanzia sul tempo totale trascorso dall’invio dei job alla consegna del risultato.
Per un esempio che richiede pochi minuti, il vantaggio può sembrare modesto. Alcuni calcoli scientifici, invece, richiederebbero anni di esecuzione continua su un PC domestico. Macchine più potenti possono ridurre quell’attesa a mesi o settimane; se il problema si presta a essere suddiviso e sono disponibili risorse sufficienti, il calcolo parallelo può abbatterla ulteriormente, fino ad arrivare all’ordine di qualche giorno o qualche ora.
09 Da π alla ricercaUn’infrastruttura comune, tante domande scientifiche
Stimare π con delle “palline” è un esempio volutamente semplice: non serve a scoprire un numero sconosciuto, né è il modo più efficiente per calcolarlo. Serve a rendere comprensibile come un problema possa essere affidato a un’infrastruttura di calcolo e distribuito tra più macchine.
IL SERVIZIO DI RECASTu porti il problema.
Tu porti il problema.
Il data center offre
le risorse per affrontarlo.
Processori, memoria, rete e strumenti di gestione permettono a tanti programmi della ricerca di trovare spazio su un’infrastruttura comune.
Al posto delle palline possono esserci simulazioni di fenomeni fisici, analisi di dati sperimentali o molti tentativi di uno stesso modello. Non tutti i problemi si dividono con la stessa facilità, ma l’obiettivo rimane quello: mettere la capacità di calcolo al servizio di una domanda scientifica.
Proprio per questo, un cluster può essere utilizzato contemporaneamente da decine di gruppi di ricerca diversi: chi studia la fisica delle particelle, chi lavora nella fisica medica, chi simula il comportamento dei fluidi, chi sviluppa previsioni meteorologiche e ambientali, chi si occupa di applicazioni biomediche o di problemi ingegneristici. Cambiano i programmi, i dati e le domande, ma l’infrastruttura e l’approccio non cambiano.
Il punto di forza di un batch system, e di un centro di calcolo come ReCaS, è mettere a disposizione una piattaforma condivisa sulla quale eseguire programmi molto diversi, senza dover costruire e gestire ogni volta un’infrastruttura dedicata. Nel rispetto delle risorse disponibili e delle regole di accesso, ogni gruppo porta il proprio lavoro; il sistema ne organizza l’esecuzione insieme a quella degli altri.
In sintesi, il centro di calcolo mette risorse condivise al servizio di problemi scientifici diversi, mentre il batch system ne organizza l’utilizzo in modo efficiente.
Opportunità e contatti.
Per proposte di collaborazione, opportunità di formazione o richieste di tesi di laurea è possibile contattare lo staff del data center all’indirizzo segreteria@recas-bari.it.
Enti di ricerca e aziende
Collaborazioni
Proposte di collaborazione scientifica e tecnologica con ReCaS-Bari.
Laureati STEM
Formazione
Informazioni su borse di studio e contratti di ricerca.
Studenti universitari
Tesi di laurea
Informazioni e richieste relative allo svolgimento di tesi di laurea presso il nostro data center.